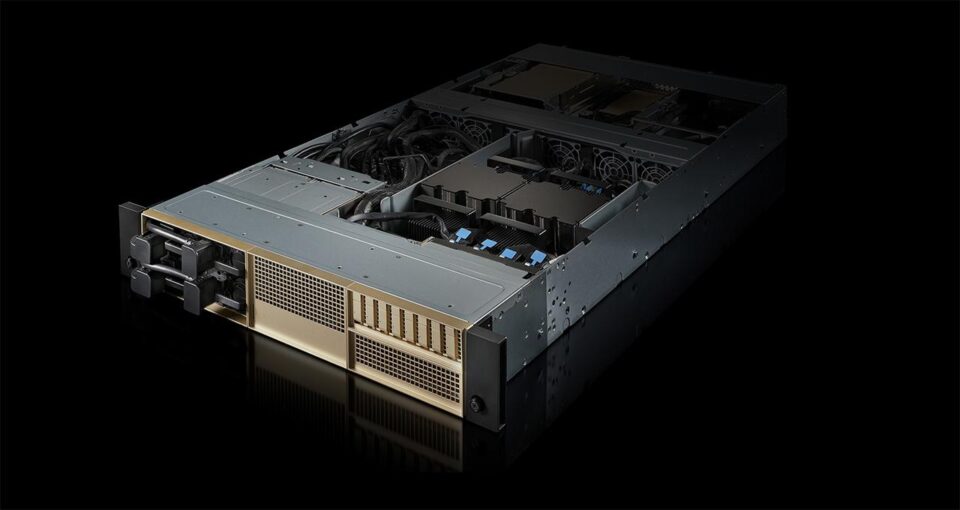
サーバーCPUの宣伝文句といえば、コア数の多さが相場でした。128コア、192コア、256コア。その流れにNVIDIAが真っ向から異を唱えています。公式ブログでVera CPUを、並列モンスターではなく大規模環境向けの最速シングルスレッドCPUだと説明したのです。エージェントAIの時代には1コアの速さこそが効く、という理屈まで添えて。本記事ではNVIDIAの主張の中身、Veraのスペック、公開された実測値、そして初めて名前が出た次世代コアRigelまで整理します。CPU選びの物差しが変わりつつある現場を見ていきましょう。
NVIDIAの主張
公式ブログの論旨はこうです。AIエージェントは、タスクを分解し、ツールを呼び、結果を確認して次の一手を決めるというループで動きます。各ステップは前の結果に依存するため、並列化では速くなりません。ループを速く回すには1コアの実行速度を上げるしかない。だからVeraはコア数を絞り、1コアあたりの性能に振り切った、と。負荷のかかった状態での持続的なコア単位性能は、x86の1.8倍だと主張しています。シングルスレッド性能はゲーミングPCでは昔からの主役ですが、サーバーの表看板に据えられるのは珍しいことです。
Veraの主なスペック
公式ブログで示された数字は次の通りです。
| 項目 | 内容 |
|---|---|
| CPUコア | 独自設計Olympusコア × 88 |
| IPC | Grace比で50%向上 |
| メモリ | LPDDR5X、帯域最大1.2TB/s |
| メモリ電力 | 40W未満(メモリサブシステム) |
| コア間帯域 | 3.4TB/s |
| ダイ構成 | モノリシック |
チップレット全盛の時代にモノリシックダイを選んだのは、コア間レイテンシを削るためだと説明されています。コア間帯域3.4TB/sは競合データセンターCPUの3倍という主張です。88コアという数は、136コアのArm AGIや96コア超のEPYCと並べると控えめですが、それこそが設計思想の表明でもあります。88という数字を弱点と見るか思想と見るかで、このチップの評価は割れるでしょう。
Perplexityの実測値
ブログには顧客の実例も載っています。検索AIのPerplexityがコーディング系ワークフローで試したところ、ジョブ完了がx86比で約1.5倍速く、サンドボックスの同時起動は1.9倍速かったとのことです。ベンダー公式ブログ経由の数字なので割り引く必要はありますが、合成ベンチではなく実ワークロードの数字を出してきた点は評価できます。エージェントが大量のサンドボックスを起動しては壊す使い方は、確かにシングルスレッド性能とメモリ応答が効く領域です。エージェントの応答待ちが短くなれば、そのままサービスの体感速度に直結します。
初公開された次世代コアRigel
ブログの終盤で、NVIDIAは次世代CPUコアの名前を明かしました。Rigelです。次期CPUのRosaに搭載される、Arm v9.2ベースの新設計コアで、命令供給の改善、L2キャッシュの拡大、より効率的なメモリ処理を図りながら、Olympusと同等のシリコン面積を維持するとされています。面積据え置きで性能を積むという方向性は、シングルスレッド重視路線の継続宣言と読めます。GraceからVera、そしてRosaへ。NVIDIAのCPUロードマップは年次のGPUと歩調を合わせて回り始めました。GraceではArmの既製コアNeoverse V2を使っていた同社が、VeraのOlympusで独自設計に切り替え、Rigelでそれを更新していく。コア設計の内製化は、もう既定路線と見てよさそうです。
サーバーCPU市場への影響
コア数競争一辺倒だった市場に、シングルスレッド性能という別の軸が持ち込まれたのは健全な変化です。エージェントAIの制御にはVera型、スループット勝負のマイクロサービスにはメニーコア型と、用途で選び分ける時代になっていくのでしょう。x86陣営もAMDのZen 6世代EPYCが控えており、反撃の材料はそろっています。日本の国家AI基盤に採用されたのもこのVeraで、実戦配備は着々と進行中です。
まとめ
NVIDIAはVeraを最速シングルスレッドCPUと位置づけ、エージェントAIのループ処理では1コアの速さが決め手になると主張しました。88コアのOlympus、x86比1.8倍というコア性能、そして次世代コアRigelの存在まで、CPU戦略の輪郭がはっきり見えてきた発表です。VeraはNVIDIAと日本政府による国家AI基盤にも採用されています。関連記事でどうぞ。